Crea modelos de IA auditables
en tus propios equipos
Descarga el Studio e instálalo en tu infraestructura: tus datos no salen de ella, salvo lo que tú decidas enviar a tu propio LLM. Di qué quieres predecir y MatrixAI pone a competir varios motores —árboles de gradiente y nuestra propia red neuronal— con una regla escrita antes de medir, elige el mejor con validación cruzada y guarda el test para la cifra final. Cada decisión dice su porqué, y la elección queda escrita en un recibo —qué compitió, qué ganó y con qué regla— que viaja con el estudio.
Qué significa eso — y qué noCómo funciona, en 4 pasos
- 01
Descárgalo e instálalo en tus equipos
Un paquete con Docker, para CPU o para GPU. Corre en tu propia infraestructura: tus datos no salen de ella, salvo lo que tú decidas enviar a tu propio LLM.
- 02
Abre tu CSV en el Studio y elige qué predecir
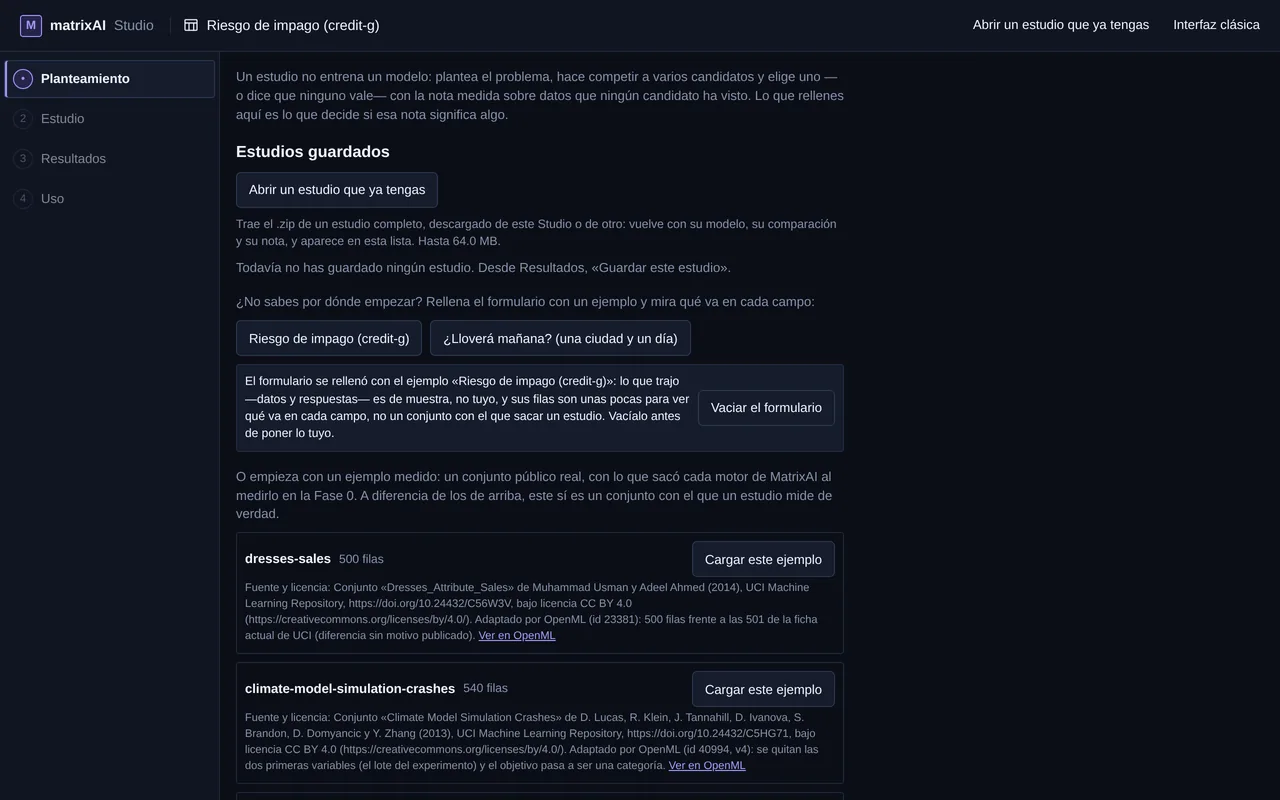
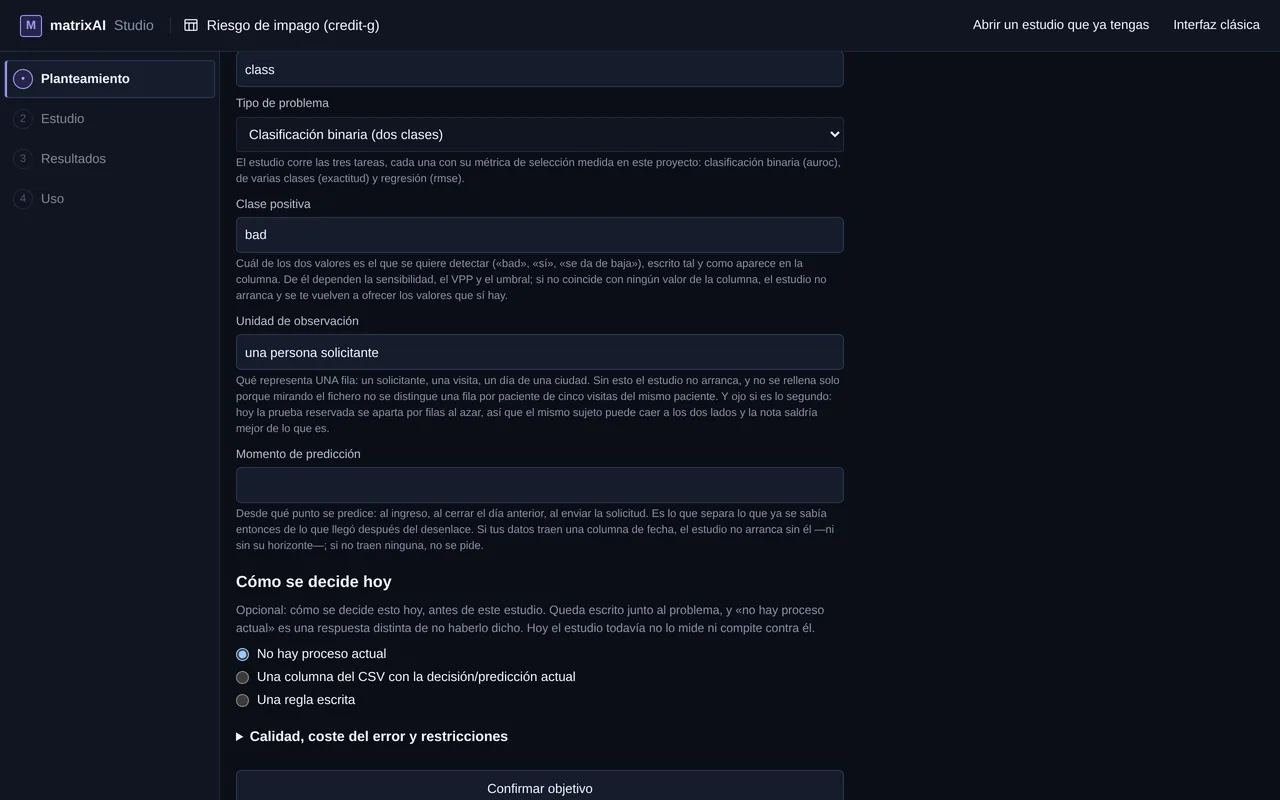
Confirmas la columna que quieres predecir y el tipo de tarea: sí o no, varias clases o un número.
- 03
Compiten los motores y se elige el de mejor media
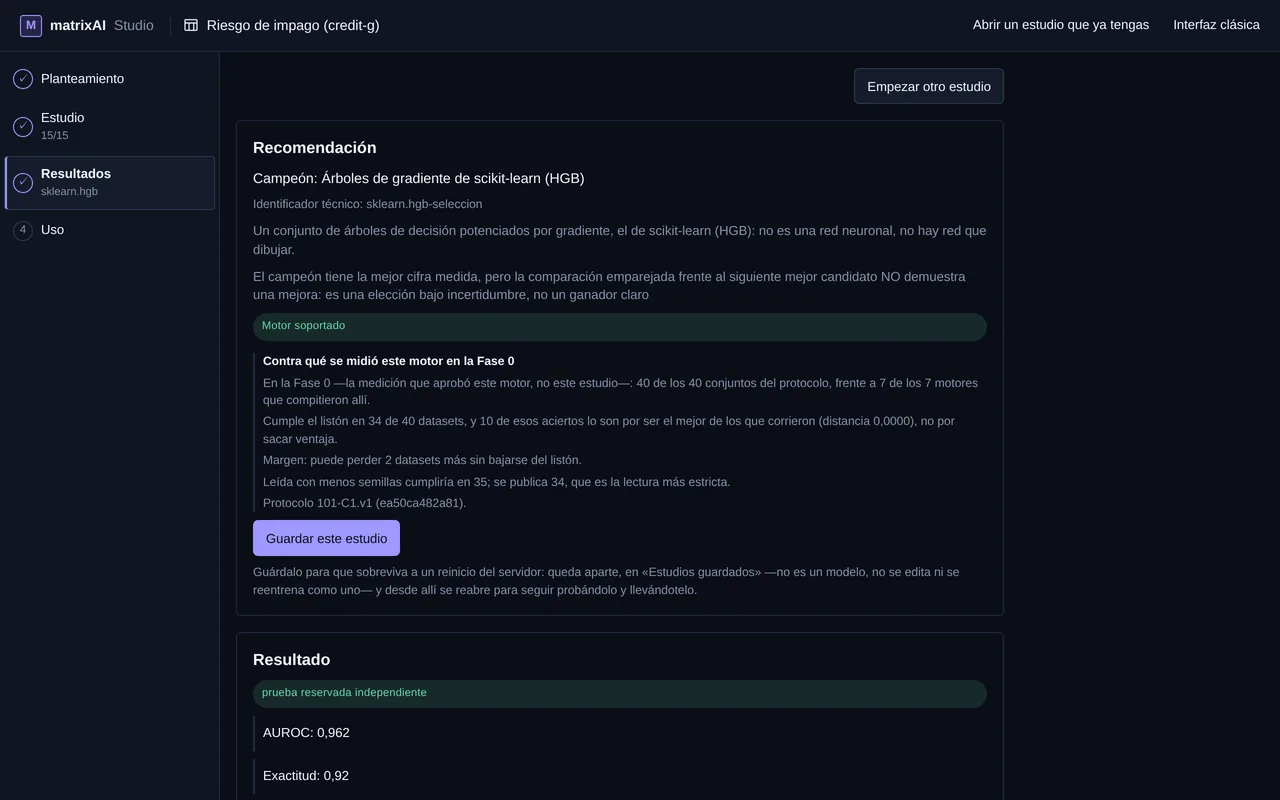
Varios motores se miden con la misma validación cruzada. Gana la mejor media, y el test se guarda para la cifra final.
- 04
Usa tu modelo y llévatelo
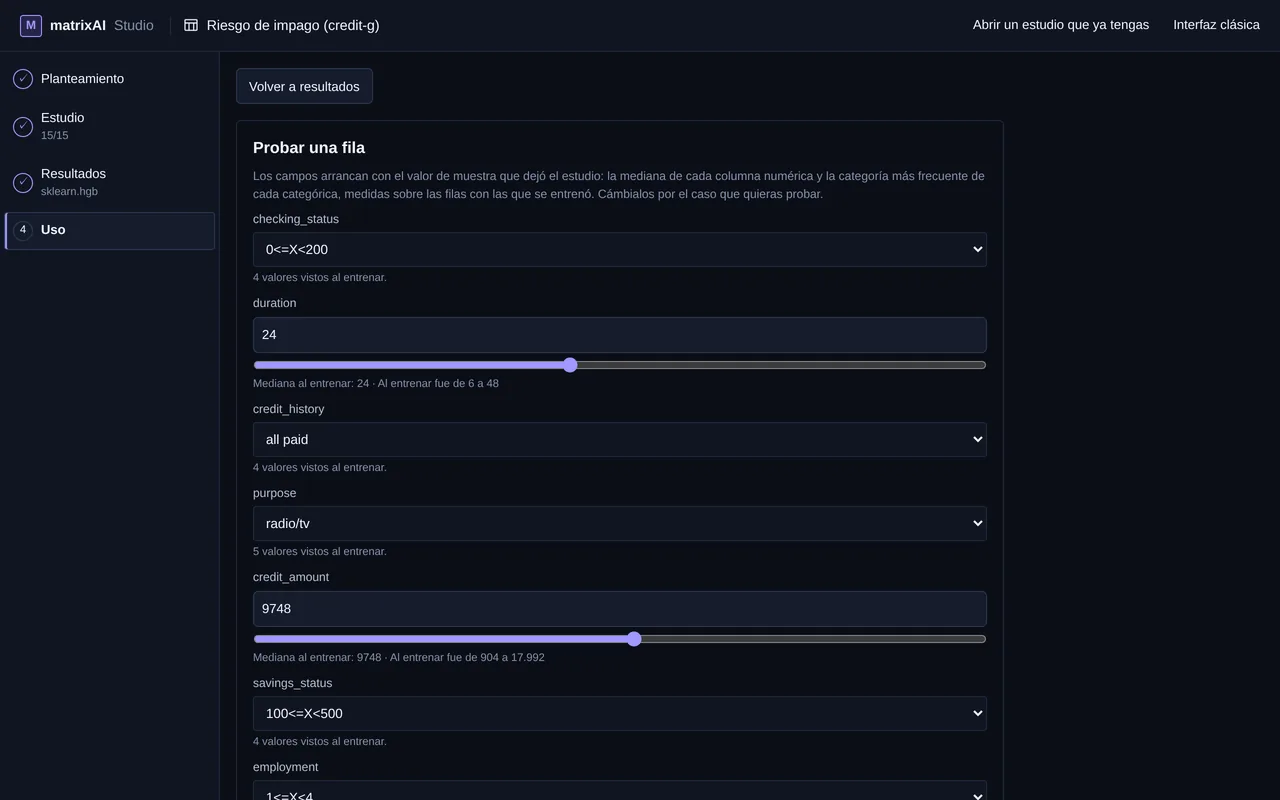
Predice con él, fila a fila o un CSV entero, y descarga el paquete. Guarda el estudio: lleva su recibo de qué compitió y por qué ganó.
Medido contra los motores de referencia
En 40 conjuntos públicos, con un protocolo escrito antes de medir, la red de MatrixAI (su arquitectura parte de TabM, de Yandex Research; la adaptación, el protocolo y la medida son nuestros) queda a 2 puntos o menos del mejor en 38 de 40 —y es la mejor en 23— frente a 6 motores, con sus valores por omisión:
| Motor | A 2 puntos o menos del mejor | El mejor en |
|---|---|---|
| Red de MatrixAI | 38 / 40 | 23 |
| LightGBM | 26 / 40 | 2 |
| CatBoost | 25 / 40 | 8 |
| scikit-learn HGB | 25 / 40 | 2 |
| XGBoost | 24 / 40 | 3 |
| scikit-learn (lineal) | 13 / 40 | 2 |
| Baseline (ingenuo) | 0 / 40 | 0 |
Estas cifras son de la Fase 0, no lo que te llevas en el producto. Esta red está en el Studio desde la v2.8: compite en el estudio, en los dos paquetes, como un motor más, y gana donde es la mejor.
Medido en el estudio del Studio, en 13 conjuntos públicos, sin GPU y con 6 GB de memoria para el contenedor. Paquete CPU: El campeón sube en 2 de 13 conjuntos (diferencia en puntos de su cifra en el test: dresses-sales +4,4, pc1 +1,6), no baja en ninguno y ninguno deja de completar. En 2 el estudio no terminó con campeón ni con la red ni sin ella. En 2 la memoria estimada superó la del contenedor y la red no compitió (Allstate_Claims_Severity: 15,3 GB estimados frente a 6 GB; KDDCup09_appetency: 7,8 GB estimados frente a 6 GB).
Paquete con GPU: El campeón sube en 3 de 13 conjuntos (diferencia en puntos de su cifra en el test: dresses-sales +4,4, house_16H +1,8, pc1 +1,6), no baja en ninguno y ninguno deja de completar. En 3 el estudio no terminó con campeón ni con la red ni sin ella. Esta pasada también se hizo sin GPU: lo que valga en una GPU no está medido.
Y desde la v2.9 se puede elegir en el modo experto, como un estudio de un solo motor medido frente a la referencia. Va recomendada para tablas tras una medición de confirmación en 8 conjuntos: quedó a 2 puntos o menos de la mejor de las tres redes en 7 de ellos (la excepción: climate-model-simulation-crashes, donde la red del estudio del núcleo la superó por 2,1 puntos). Su tiempo está medido, no prometido; el plazo cortó 1 de los 22 pliegues medidos (mfeat-factors).
Así medimos cada motor que compite en el estudio. Cómo medimos →
Qué sabe hacer
La elección queda escrita con su porqué
El test se guarda para el final
Tus datos se quedan contigo
Llévate el modelo
Precio
El motor es gratis. El paquete Studio, 2 €.
El motor es código abierto y lo seguirá siendo siempre. El paquete Studio quita toda la fricción de la instalación para que tu equipo produzca desde el primer minuto.
MatrixAI Core
- ✓Motor completo · listo para producción
- ✓Interfaz de línea de comandos
- ✓API REST + Swagger
- ✓Exportación a ONNX / WASM de las redes del core
- ✓GPU opcional · listo para Docker
- ✓AGPL v3 — código abierto de verdad