Qué consigues —
y qué no
MatrixAI Studio corre en tu propio equipo. Planteas el problema y pone a competir varios motores sobre tus datos, elige el ganador por la media de una validación cruzada, guarda el test para la cifra final y te dice por qué — cada decisión con su motivo, y la elección escrita en un recibo. Si prefieres construir tú una red, el modo experto sigue ahí. Hay una demo en el navegador con datos de ejemplo, el core es AGPL y los manuales enseñan cada pantalla. Esta página dice para qué sirve — y, con la misma claridad, para qué no.
Todas las capturas de esta página se tomaron conduciendo el producto de verdad — las del estudio, de la misma sesión que el tour del Studio; las del modo experto, de la del manual. Cada número está medido; donde un resultado fue malo, se enseña malo. Aquí no hay maquetas. Las cuatro primeras secciones son el camino principal, el estudio; el resto es el modo experto, y está rotulado como tal.
Varios motores compiten — y el campeón dice por qué
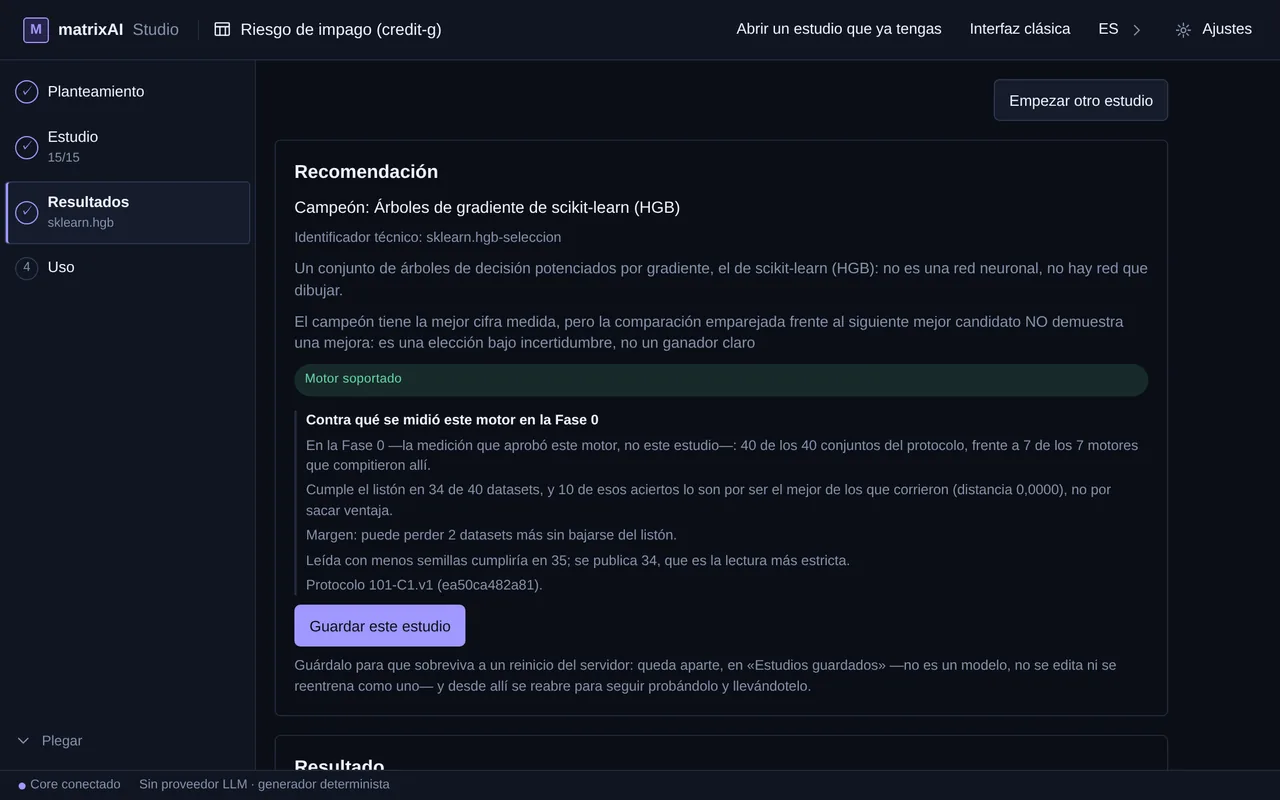
Planteas el problema —el objetivo, el tipo de problema, qué representa una fila— y el estudio prueba cada motor sobre varias partes de tus datos de desarrollo, cada una con su propia validación cruzada. El paquete estándar enfrenta árboles de gradiente (LightGBM y scikit-learn) a un modelo de referencia y, desde la v2.8, a nuestra propia red neuronal (en los dos paquetes, con su propio tiempo: 60 s por intento, sumados al presupuesto, así que ningún otro motor pierde un segundo). Solo compite si se midió en todas las partes de la validación cruzada, y el estudio elige por conjunto: gana únicamente donde es la mejor. El paquete con GPU conserva además nuestra red anterior, como motor experimental; en el paquete CPU la ocupa la red nueva. El campeón es el de mejor media entre sus partes, y la pantalla lo nombra, dice qué es ese motor y da la razón en palabras llanas. Cuando la comparación pareada con el segundo no muestra una mejora, lo dice también: una elección bajo incertidumbre, no un ganador claro. Unos pocos motores, no cientos, y sin búsqueda de hiperparámetros.
El test queda apartado y la evidencia queda escrita
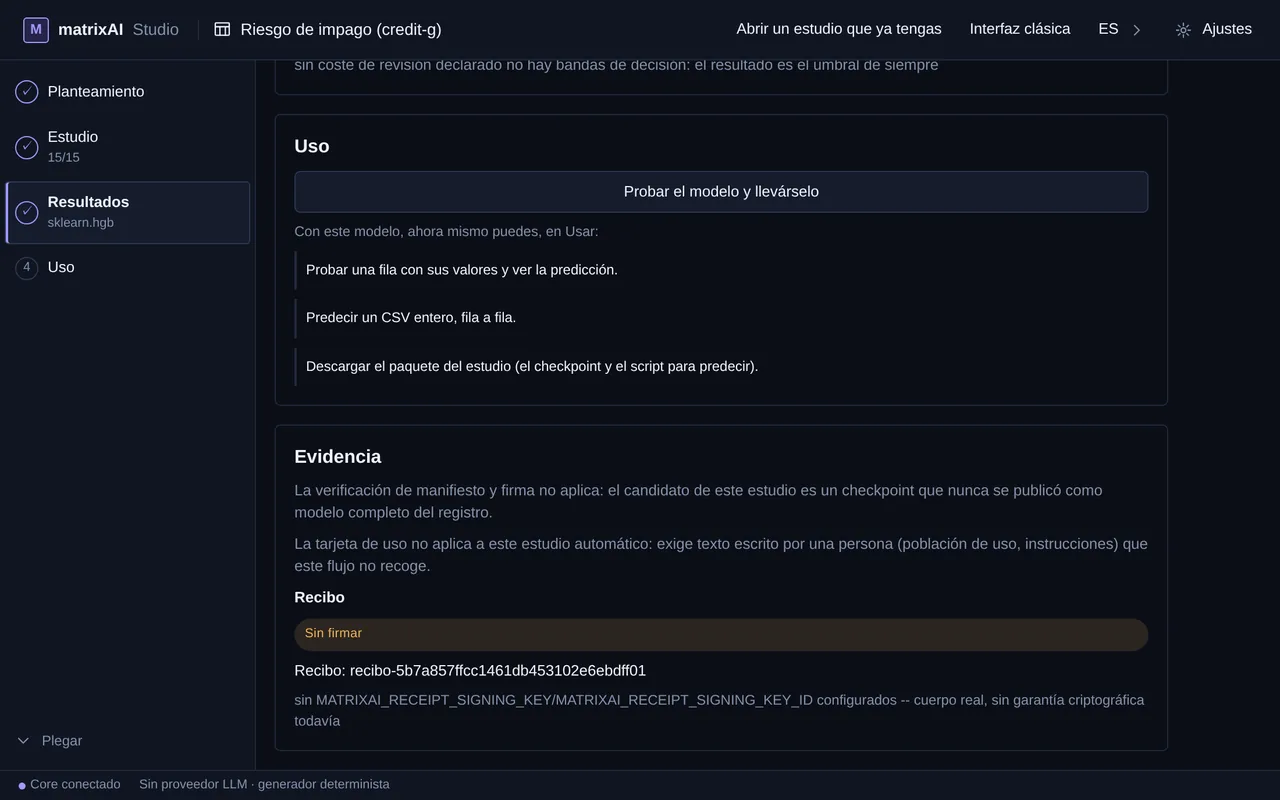
La cifra que cuenta sale de datos que ningún candidato vio mientras competía: el test se guarda intacto hasta el final, y la comparación enseña la media de cada motor entre sus partes —la que decide— con su rango, para que una partición con suerte no elija al campeón. Debajo, la evidencia dice qué aplica y qué no, y por qué, y el recibo recoge qué compitió, qué ganó y bajo qué regla. El recibo sale Sin firmar hasta que configuras tu propia clave de firma; su firma es un HMAC, así que un tercero no puede verificarla sin esa clave. Documenta la elección — no es un certificado.
El paquete del ganador, y el estudio entero
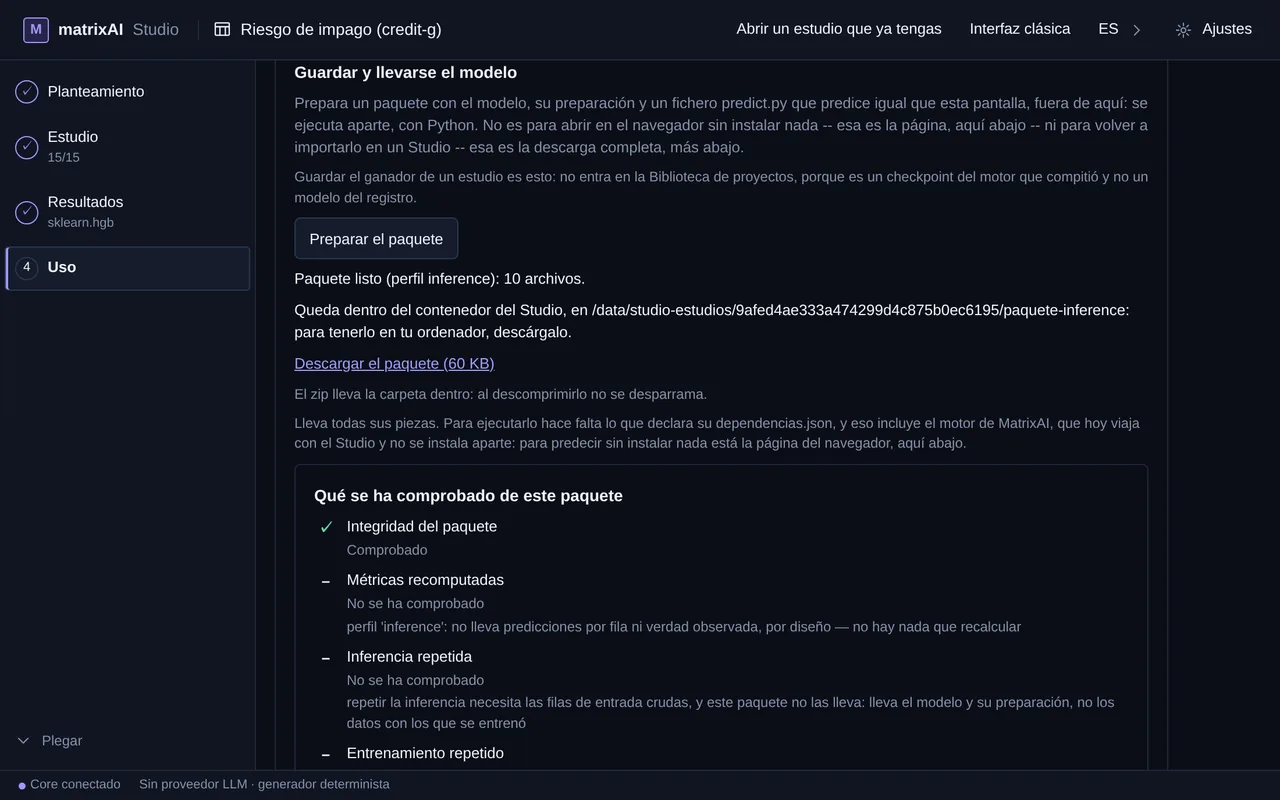
Preparas el paquete y sale el ganador con su receta de preparación y un predict.py que predice como lo hace la pantalla — con Python, fuera del Studio, pero necesita los motores del Studio: en una máquina sin ellos no corre. El recibo no va en ese paquete: viaja en estudio-completo.zip, el estudio entero, que reabres en otro Studio. Una página que predice en el navegador (ONNX) solo se ofrece cuando gana LightGBM en una clasificación binaria, con su decisión elegida y sin columnas de fecha; si no, la opción sale apagada con su motivo. Tus datos no salen de tu equipo — salvo las 5 filas y las cuentas que envíes a tu LLM si marcas la propuesta opcional que se describe más abajo.
El LLM puede proponer el planteamiento — y tú lo confirmas
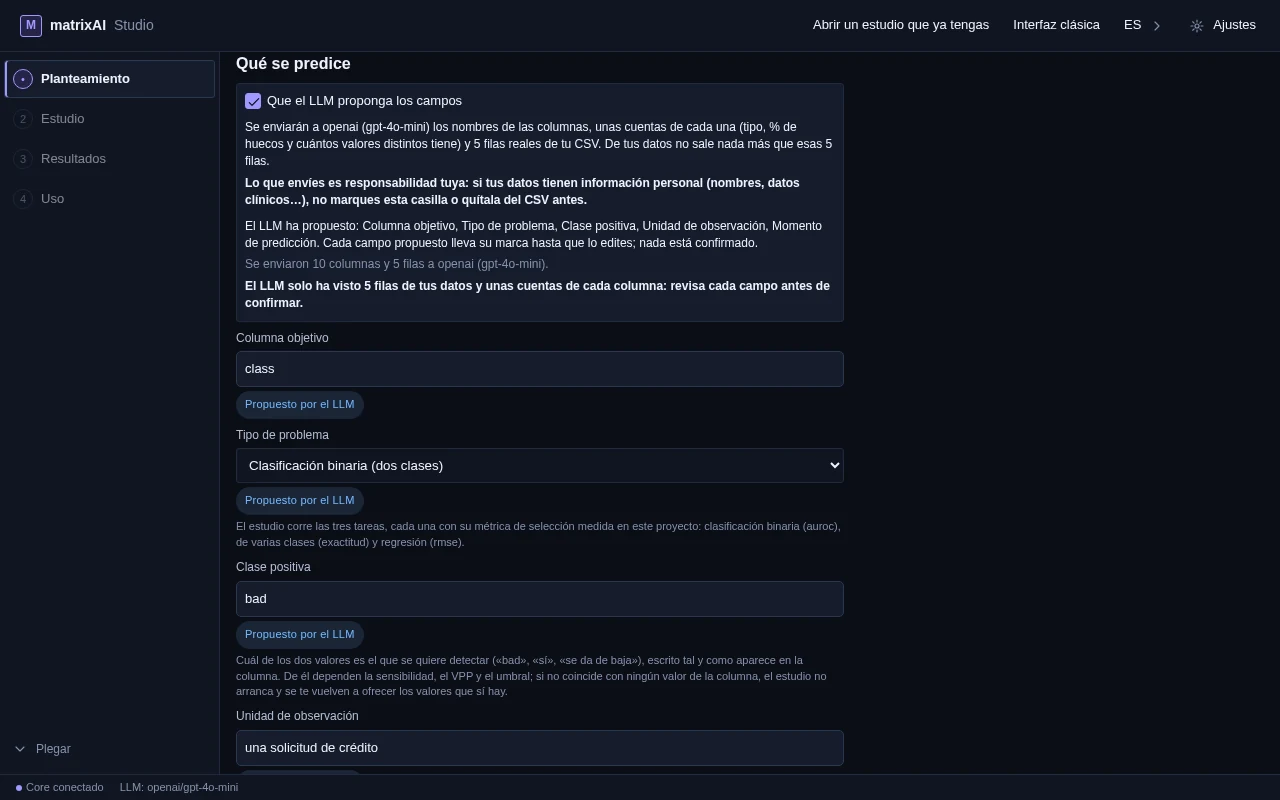
Si tienes un LLM configurado en Ajustes, puedes marcar «Que el LLM proponga los campos». Entonces propone los campos vacíos del planteamiento — columna objetivo, tipo de problema, clase positiva, unidad de observación, momento de la predicción y horizonte— y cada campo propuesto lleva su marca «Propuesto por el LLM» hasta que lo editas. Lo que sale: los nombres de las columnas, unas cuentas de cada una (tipo, % de huecos, valores distintos) y 5 filas reales de tu CSV, hacia el LLM configurado en ese momento, que el aviso nombra antes de que marques. Lo que envíes es responsabilidad tuya: con datos personales, no marques la casilla o quítalos del CSV antes. Lo que no hace: no rellena lo que ya escribiste, no confirma nada —revisas y confirmas tú—, necesita un LLM configurado y no está en la demo alojada. Sin la marca, esto no envía nada.
O construye tú una red
El modo experto sigue en el producto, detrás de un interruptor: Activar el modo experto en la portada del Studio. Ahí describes un modelo con una frase, subes un CSV o partes de una plantilla, y el core construye esa red, fase a fase — el modo de trabajo que tenía el Studio antes del estudio. Es otra herramienta: en él no compite ningún motor. Lo que sigue es lo que te da el modo experto.
Descríbelo — el esquema queda sobre la mesa
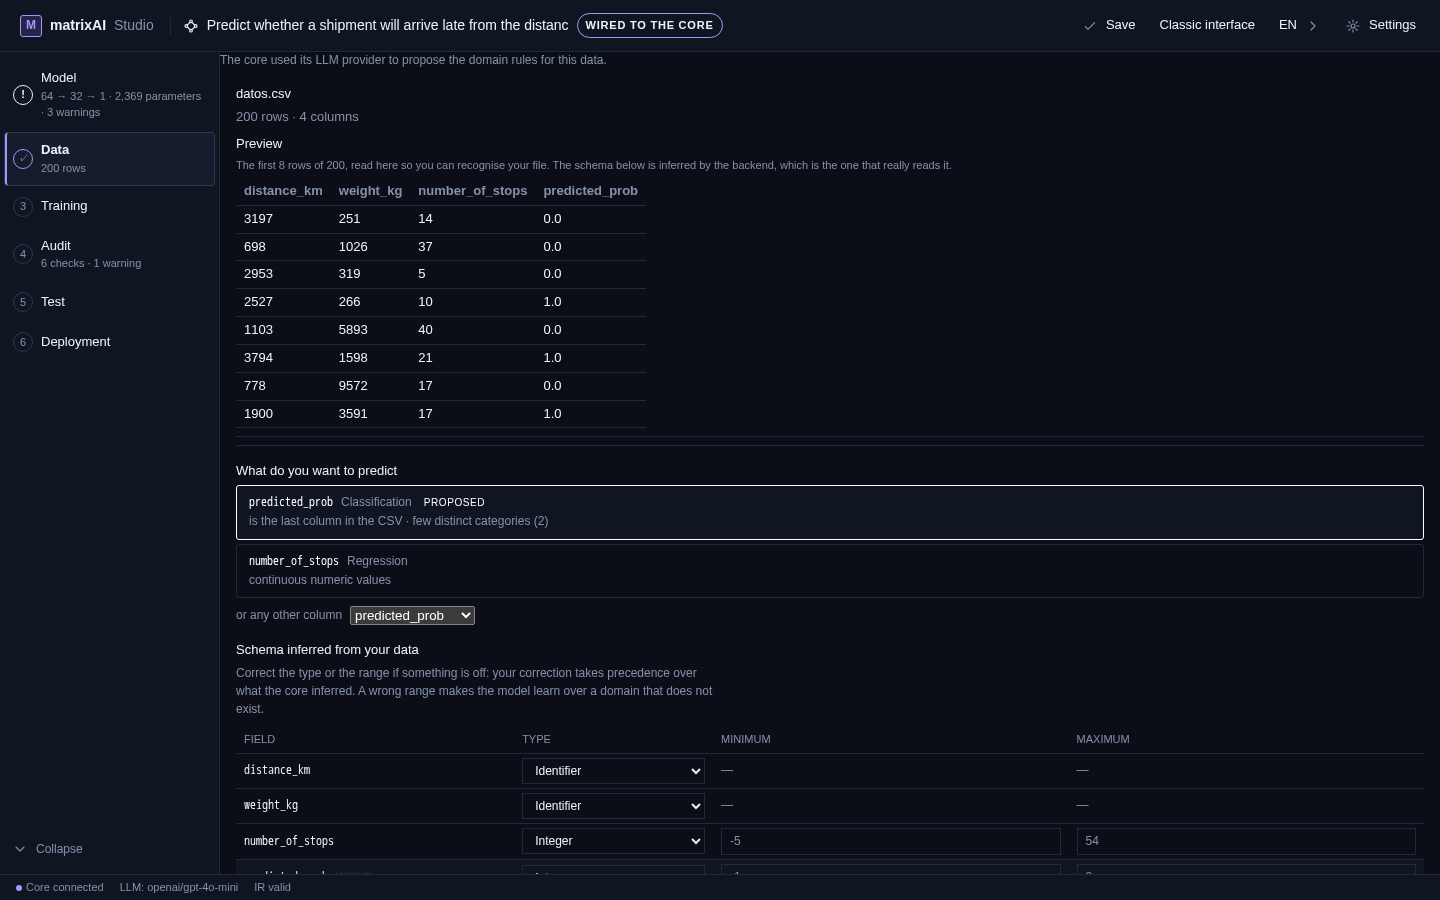
Tres puertas: una frase, tu CSV, o una plantilla del catálogo. Entres por donde entres, el core lee los datos, propone un objetivo con su porqué — y la alternativa que consideró — e imprime el esquema que infirió: cada campo, su tipo, su rango, todo editable. Él propone; tú decides. Y la pantalla te avisa de la parte que importa: un rango mal puesto hace que el modelo aprenda sobre un dominio que no existe.
Una traza con nombres y apellidos
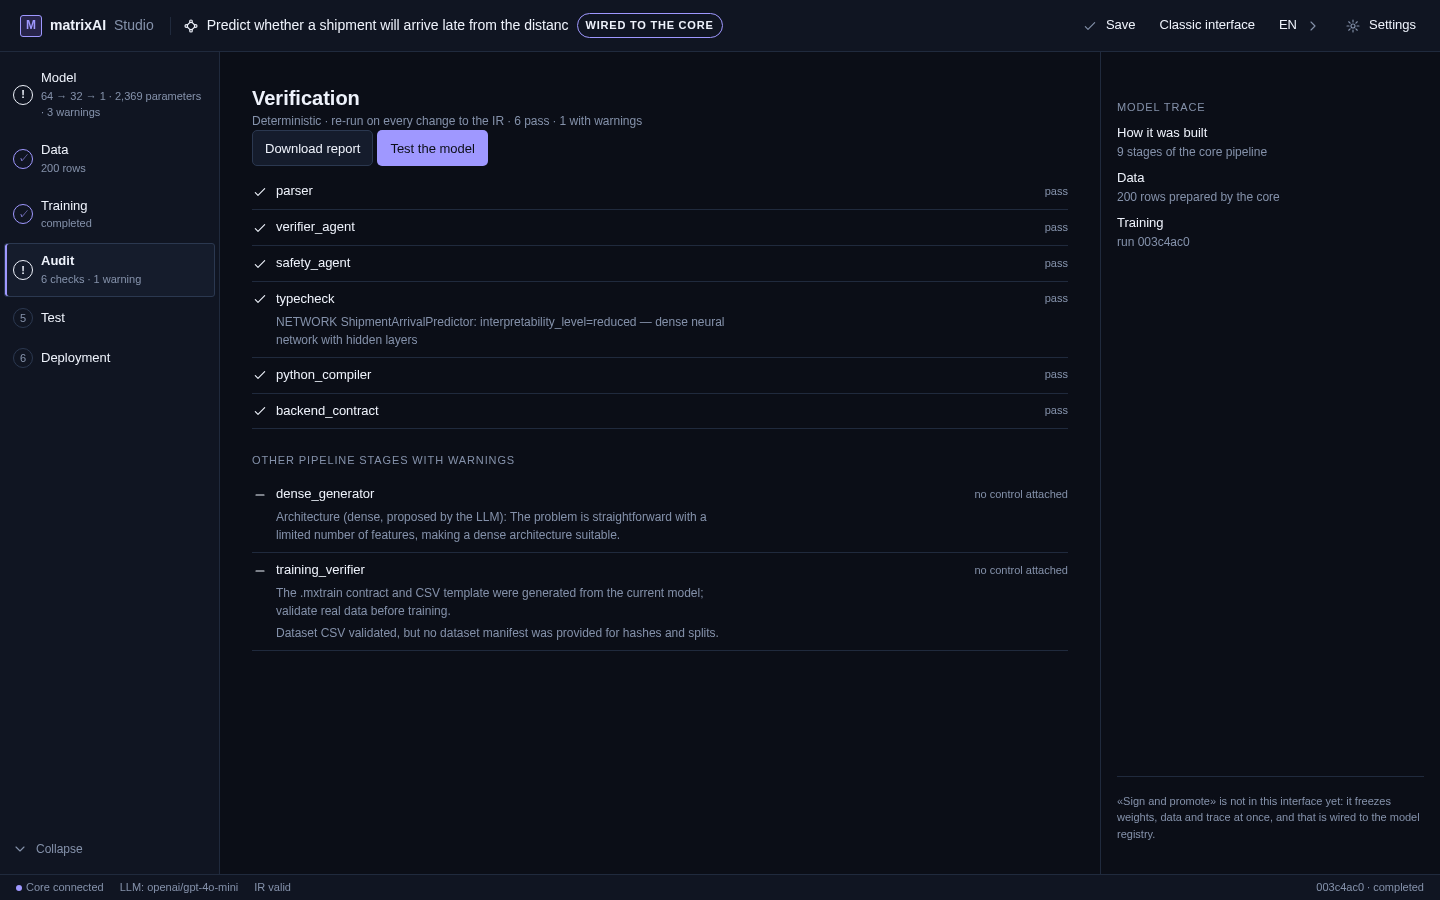
La auditoría no es un resumen del entrenamiento. Seis comprobaciones corren contra el propio modelo — parser, verifier_agent, safety_agent, typecheck, python_compiler, backend_contract — y se repiten con cada cambio, así que el veredicto no puede caducar a tus espaldas. Las etapas del pipeline que no tienen aprobado/suspenso se listan aparte con lo que sí declararon, en vez de desaparecer bajo un tic verde. La verificación entera se descarga como fichero, y la traza une el modelo con los datos con que se preparó y con el entrenamiento al que pertenece.
Comprobado antes de mover un solo peso
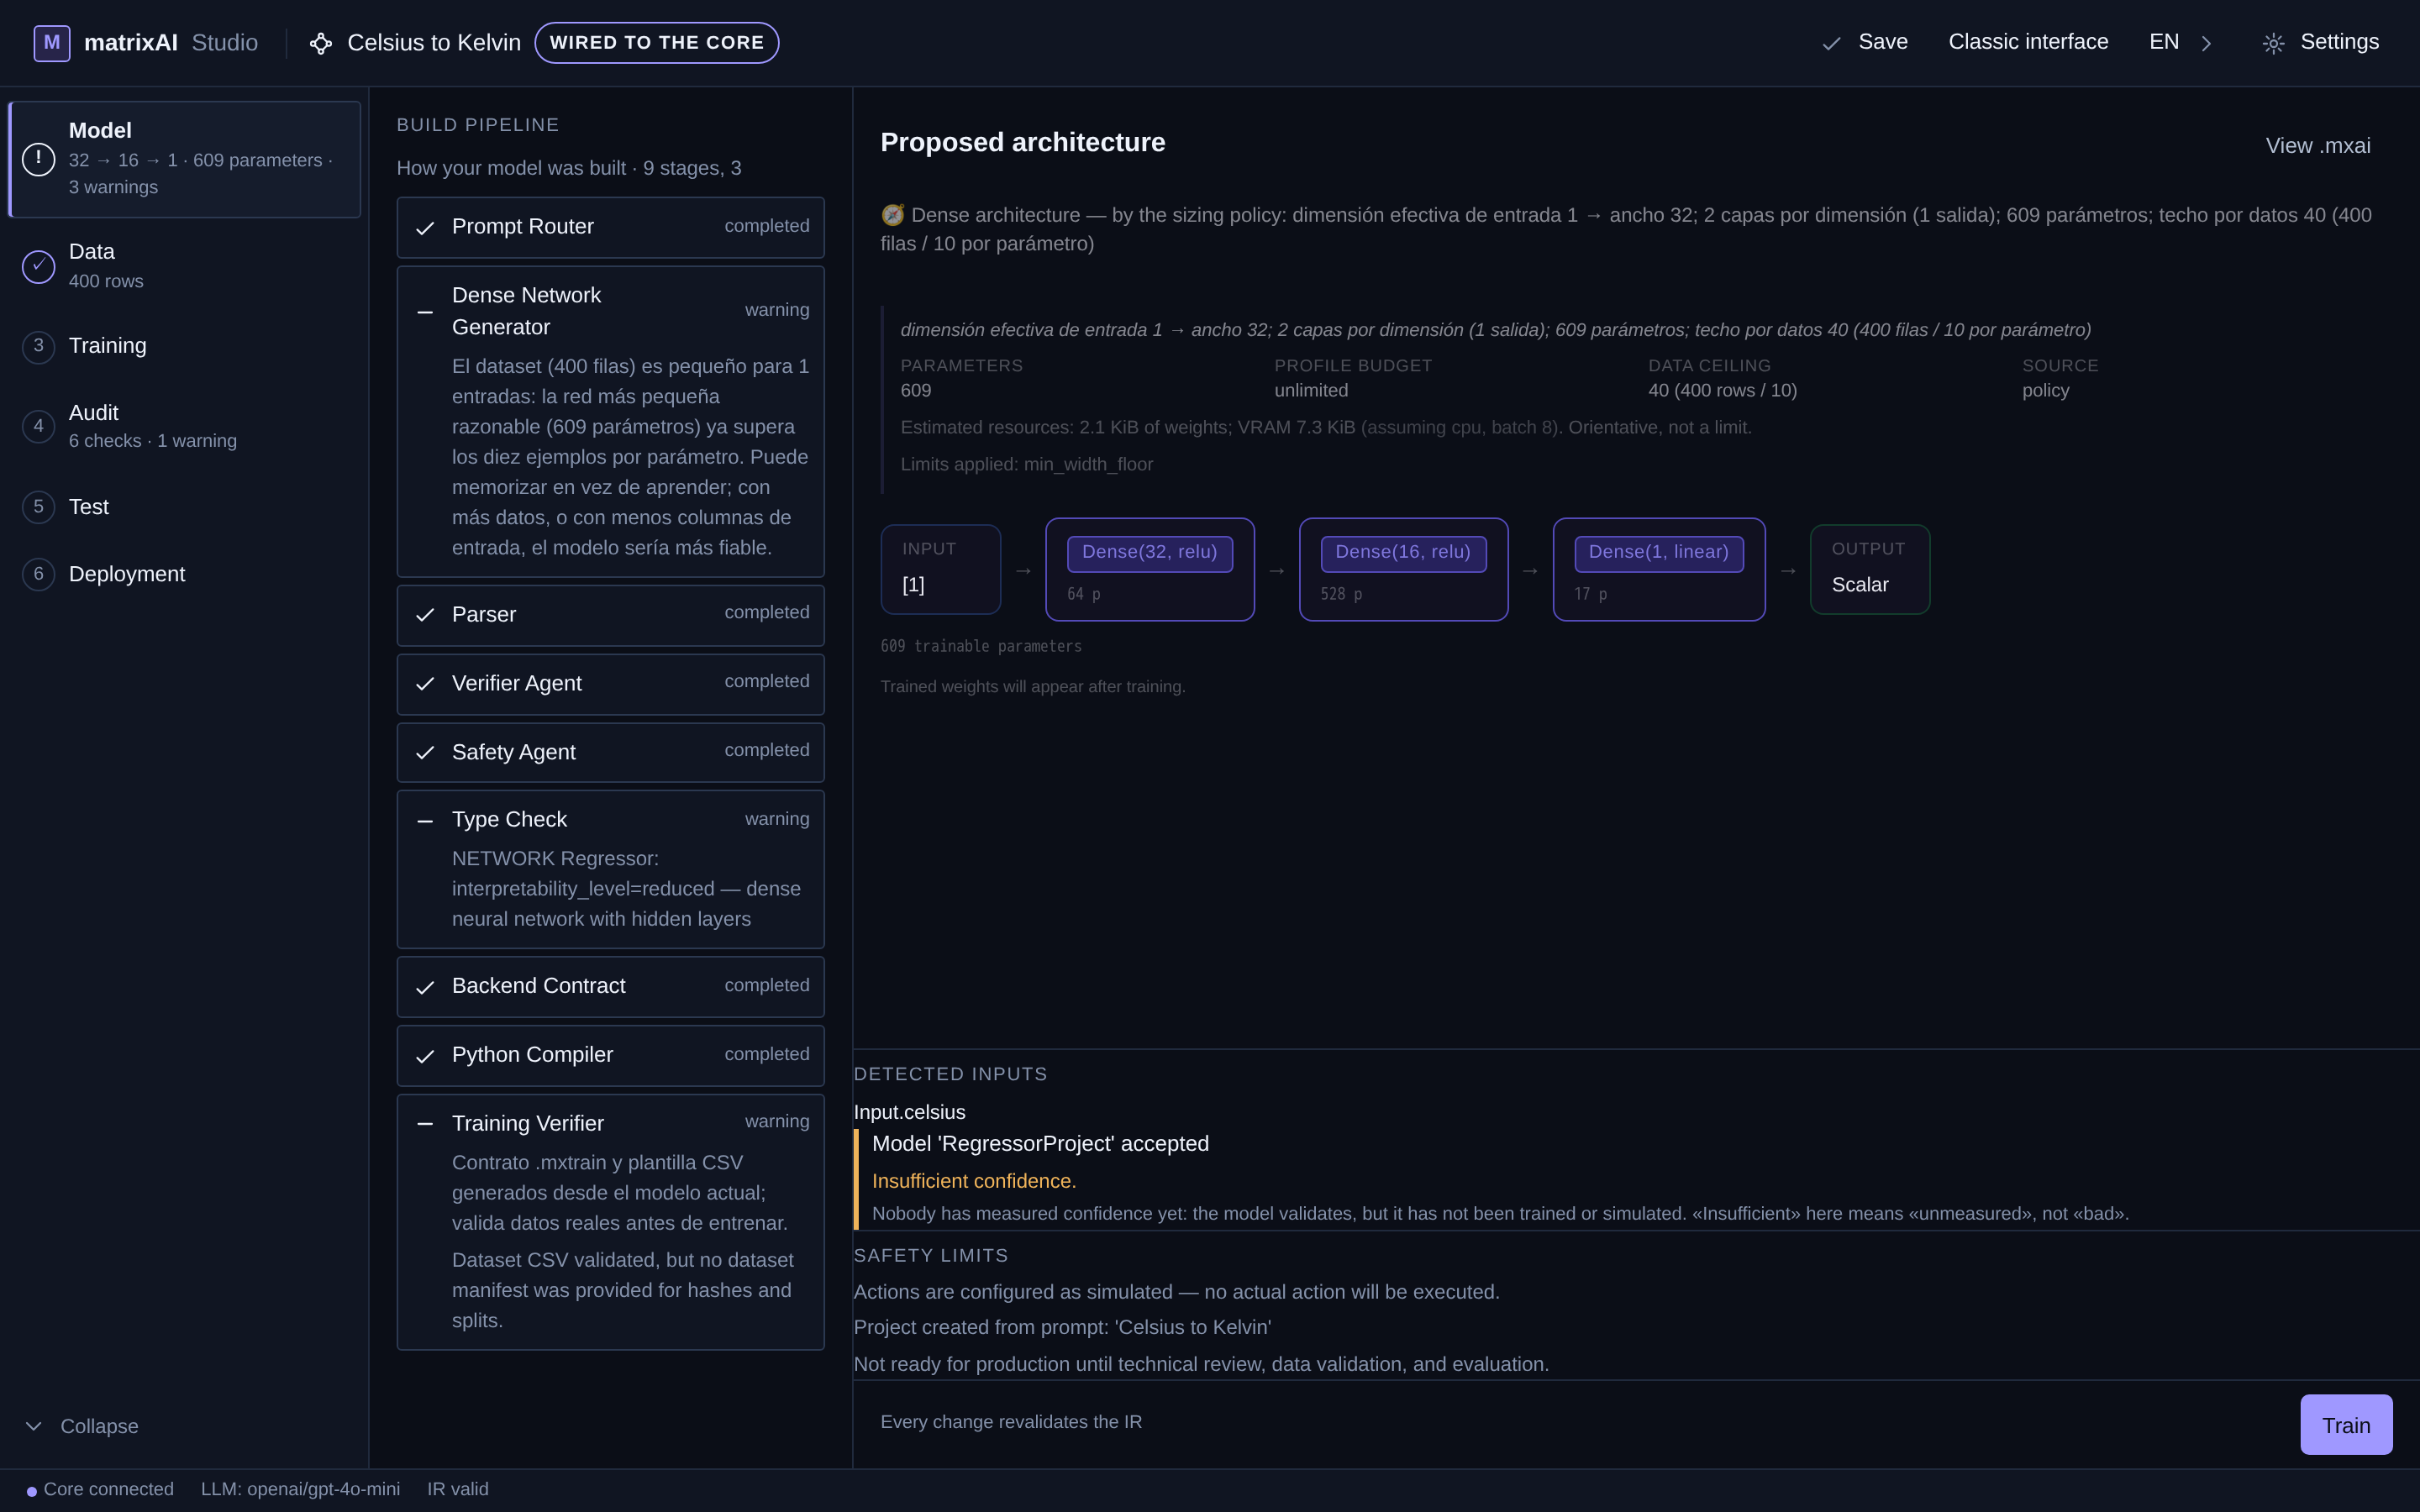
Antes de entrenar, el modelo ya es un objeto que se puede verificar: el chequeo de tipos tipa la red y declara su nivel de interpretabilidad, y el número de parámetros se imprime para que puedas rehacer la cuenta tú mismo — una red 64 → 32 → 1 sobre tres entradas son 2.369 parámetros, y eso es lo que dice la pantalla. La estimación de recursos llega con cifras, no con adjetivos, y funciona en los dos sentidos: un modelo pequeño anuncia kilobytes, y al pedirle una red de 2.953.150.466 parámetros la respuesta fue que entrenarla pide ~26,8 GiB — la demo alojada la rechaza directamente, y el Studio descargable enseña el aviso con sus cifras y te deja decidir. Una herramienta que te dice la factura antes de comprometerte es la diferencia entre una estimación y una promesa.
Su export predice sin MatrixAI
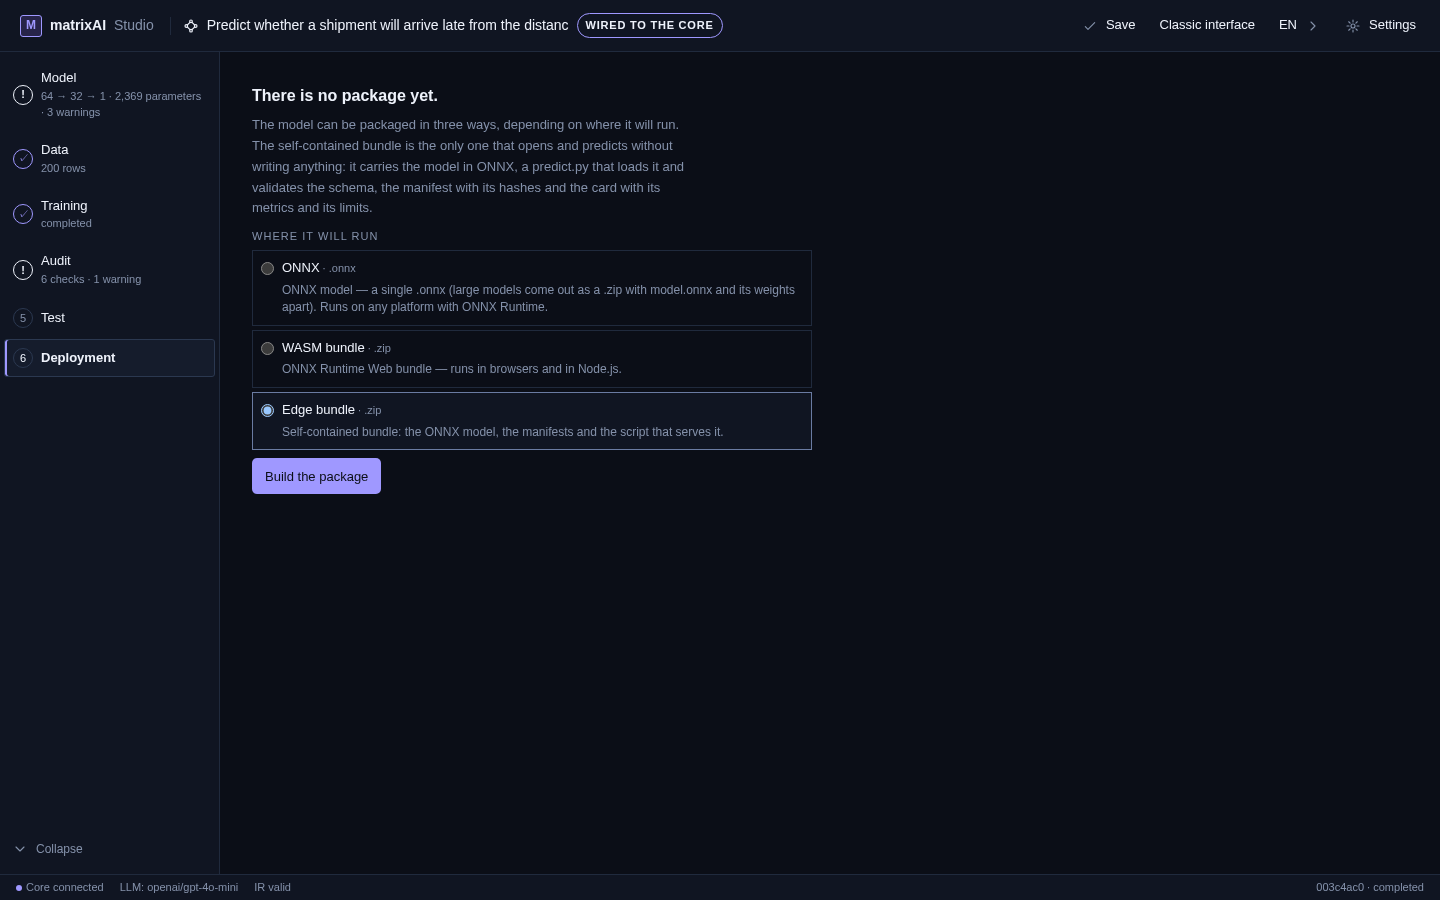
Este es el export del modo experto, no el paquete del estudio. El paquete autocontenido lleva el modelo en ONNX, un predict.py que lo carga y valida el esquema, el manifiesto con sus hashes y la ficha del modelo con sus métricas y sus límites. Le das valores crudos — sin MatrixAI instalado, sin servicio al que llamar. Y la paridad está medida, no supuesta: en una auditoría de agosto de ese export, el modelo exportado, cargado con un ONNX runtime a secas, devolvió la misma respuesta que el Studio en las seis entradas de prueba — seis de seis.
Datos reales, límites declarados: la lluvia de mañana en Santander
El catálogo de plantillas incluye un caso construido sobre cinco años de historia diaria real de Santander (Open-Meteo): temperaturas, presión, humedad, viento, nubosidad, punto de rocío y la lluvia de hoy, con el objetivo construido desplazando la lluvia un día hacia atrás — cada fila predice mañana usando solo lo que se sabía ese día, nunca datos del futuro. La ficha lleva además, en rojo y antes de crear nada, el límite de sus datos: no permiten uso comercial. Al lado, un caso de altura de olas sobre cinco años de datos marinos horarios reales. Ese es el patrón en todas partes: para qué sirve algo y para qué no, impreso donde decides.
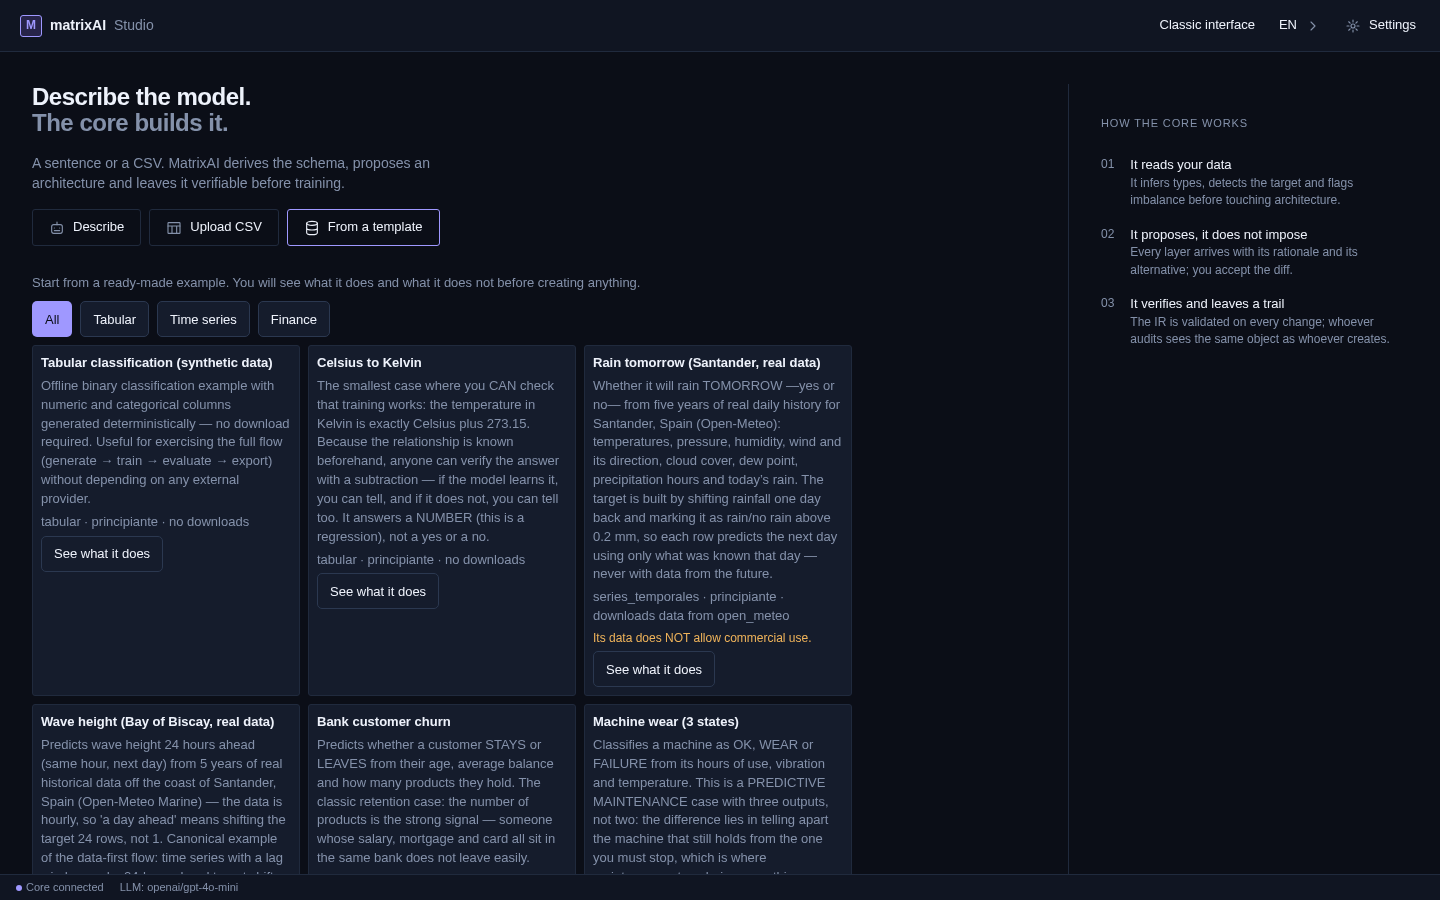
El ciclo completo del modo experto, pantalla a pantalla, está en su manual — capturado de una sesión conducida y honesto con sus números: su recorrido entrena sobre filas generadas y declara un resultado a nivel de azar como exactamente eso, porque enseñar que el producto declara un mal entrenamiento vale más que una captura más bonita. El camino principal, el estudio, está en el tour.
Lo que no hace
Este producto declara sus límites en cada pantalla, y esta página sigue la misma regla. Léelos antes de descargar — después, el resto cuesta menos de creer.
Pruébalo sin instalar nada
La demo corre en el navegador contra el core de verdad, con datos de ejemplo — sin cuenta y sin instalar nada. Tiene límites: el entrenamiento tiene tope de épocas y de segundos, no exporta modelos, y un fichero que subas ahí va a nuestro servidor, cosa que la descarga nunca hace. El tour y los manuales enseñan cada pantalla del Studio de verdad desde sesiones conducidas. El core es AGPL, en GitHub. Cuando lo quieras en tu máquina, la descarga es un ZIP y un script.